Plánování proti stárnutí ve frontách na jednom serveru: Systematická a srovnávací studie, část 2
Jul 25, 2023
V. ZÁSADY ZALOŽENÉ NA AOI
V části IV jsme ukázali, že politiky založené na velikosti dosahují lepšího průměrného výkonu AoI/PAoI než politiky, které nejsou založeny na velikosti. Politiky založené na velikosti však nevyužívají informace o čase příjezdu, což také hraje důležitou roli při snižování AoI. V této části navrhujeme tři zásady plánování založené na AoI, které využívají jak velikost aktualizace, tak informace o době příchodu ke snížení AoI. Výsledky naší simulace ukazují, že tyto zásady založené na AoI překonávají zásady, které nejsou založeny na AoI.
Glykosid cistanche může také zvýšit aktivitu SOD v srdeční a jaterní tkáni a významně snížit obsah lipofuscinu a MDA v každé tkáni, účinně zachycovat různé reaktivní kyslíkové radikály (OH-, H₂O₂ atd.) a chránit před způsobeným poškozením DNA. OH-radikály. Cystanche fenylethanoidové glykosidy mají silnou schopnost vychytávání volných radikálů, vyšší redukční schopnost než vitamín C, zlepšují aktivitu SOD v suspenzi spermií, snižují obsah MDA a mají určitý ochranný účinek na funkci membrány spermií. Polysacharidy Cistanche mohou zvýšit aktivitu SOD a GSH-Px v erytrocytech a plicních tkáních experimentálně senescentních myší způsobených D-galaktózou, stejně jako snížit obsah MDA a kolagenu v plicích a plazmě a zvýšit obsah elastinu. dobrý čisticí účinek na DPPH, prodlužuje dobu hypoxie u senescentních myší, zlepšuje aktivitu SOD v séru a oddaluje fyziologickou degeneraci plic u experimentálně senescentních myší Experimenty prokázaly, že Cistanche má dobrou antioxidační schopnost s buněčnou morfologickou degenerací a má potenciál být lékem k prevenci a léčbě nemocí stárnutí kůže. Zároveň má echinakosid v Cistanche významnou schopnost vychytávat volné radikály DPPH a má schopnost vychytávat reaktivní formy kyslíku a bránit volnými radikály indukované degradaci kolagenu a má také dobrý reparační účinek na poškození aniontů volnými radikály thyminu.

Klikněte na Cistanche Portugal
【Další informace:george.deng@wecistanche.com / WhatApp:{0}}】
Začneme s definicemi tří zásad založených na AoI, které se pokoušejí optimalizovat AoI v konkrétním budoucím časovém okamžiku ze tří různých perspektiv:
• AoI drop early (ADE): Když se server uvolní, rozhodne se poskytnout aktualizaci tak, že jakmile bude doručena, AoI klesne co nejdříve.
• Pokles AoI na nejmenší (ADS): Když se server uvolní, rozhodne se poskytnout aktualizaci tak, že jakmile bude doručena, AoI klesne na co nejmenší hodnotu.
• AoI drop Most (ADM): Když se server uvolní, rozhodne se poskytnout aktualizaci tak, že jakmile bude doručena, AoI klesne co nejvíce.
Pokud jsou všechny aktualizace čekající ve frontě zastaralé, výše uvedené zásady se rozhodnou poskytovat aktualizaci s nejmenší velikostí.
Ačkoli jsou všechny tyto zásady založené na AoI docela intuitivní, chovají se velmi odlišně. Abychom vysvětlili rozdíly mezi těmito politikami založenými na AoI, uvádíme příklad na obr. 7, který ukazuje, jak se AoI vyvíjí podle těchto politik. Předpokládejme, že když je podávána (i−1) první aktualizace, tři nové aktualizace (tj. i-tá, (i plus 1) a (i plus 2) a aktualizace) přicházejí postupně v čase ti, ti plus 1 , respektive ti plus 2. Velikosti těchto aktualizací vyhovují S i < S i plus 1 < S i plus 2. Když se server uvolní poté, co dokončí poskytování (i − 1) aktualizace v čase t I 0−1, ADE, ADS a ADM se rozhodnou poskytovat i-tou, (i plus 1) a (i plus 2) a aktualizace. Je to proto, že poskytování i-té aktualizace vede k nejčasnějšímu poklesu AoI v čase t I 0 (po červené křivce), poskytování (i plus 1) aktualizace vede k poklesu AoI na nejmenší v čase t I 0 plus 1 (po modré křivce) a poskytování (i plus 2) a aktualizace vedou k největšímu poklesu AoI v čase t I {{20}} plus 2 (po zelené křivka). ADE, ADS a ADM mají za cíl optimalizovat AoI v konkrétním budoucím časovém okamžiku (tj. budoucí dodací lhůta zvolené aktualizace) s různými krátkozrakými cíli. Všimněte si, že na první pohled mohou ADS a ADM vypadat stejně. Ve skutečnosti by byly ekvivalentní, kdyby se události poklesu AoI odehrály ve stejný okamžik. Tyto dvě zásady se však liší, protože časové okamžiky, ve kterých AoI poklesne, nemusí být nutně stejné (např. t I 0 plus 1 vs. t I 0 plus 2 na obr. 7). Navíc ADE a SJF mohou také na první pohled vypadat stejně. Ve skutečnosti by tyto dvě zásady učinily stejné rozhodnutí (tj. zvolily nejmenší aktualizaci, která má sloužit), když nejmenší aktualizace vede k poklesu AoI. Dělají však jiná rozhodnutí, když nejmenší aktualizace nevede k poklesu AoI. Příklad je poskytnut na obr. 8 pro ilustraci klíčového rozdílu. Na obr. 8, poté, co (i − 1) aktualizace dokončí službu v čase ti 0−1, čekají na doručení dvě aktualizace: (n−2) a aktualizace a i-tá aktualizace. Předpokládejme, že velikost aktualizace a doba příchodu těchto dvou aktualizací vyhovují následujícímu: S i−2 < SI a ti−2 < ti−1 < ti. ADE se rozhodne poskytovat i-tou aktualizaci, která vede k dřívějšímu poklesu AoI (viz obr. 8(a)), zatímco SJF se rozhodne obsluhovat (i − 2) a aktualizaci, která má menší velikost (viz obr. 8(b) ).

Dále provedeme rozsáhlé simulace, abychom prozkoumali výkon AoI těchto zásad založených na AoI. Na obr. 9 uvádíme výsledky simulace průměrného výkonu AoI politik založených na AoI ve srovnání s reprezentativní politikou založenou na čase příchodu (tj. LCFS) a reprezentativní politikou založenou na velikosti (tj. SJF). Všechny zde uvedené zásady nejsou preventivní; o preventivních případech bude pojednáno v části VI.
Na obr. 9(a) pozorujeme, že většina politik založených na AoI je o něco lepší než politik nezaložených na AoI, ačkoli jejich výkony jsou velmi blízké. Mezi zásadami založenými na AoI je ADE nejlepší, ADM nejhorší a ADS je něco mezi tím. To není překvapující, že ADM je nejhorší: Ačkoli ADM má největší pokles AoI, je to za cenu, že bude muset nejprve počkat, dokud se AoI nestane velkým. To, že je ADE nejlepší, naznačuje, že dát vyšší prioritu malým aktualizacím (aby AoI klesly co nejdříve) je dobrá strategie. Na Obr. 9(b) a 9(c), podobná pozorování mohou být provedena pro velikost aktualizace podle Weibullových distribucí.
Výše uvedená pozorování vedou k následujícímu návodu:
Směrnice 4. Využití jak velikosti aktualizace, tak informací o době příchodu může dále zlepšit výkon AoI. Přínos se však zdá být marginální.

VI. PREEMPTIVNÍ, INFORMATIVNÍ ZÁSADY ZALOŽENÉ NA AOI
V části IV jsme si všimli, že preemptivní politiky mají několik výhod a fungují lépe než nepreemptivní politiky. V této části nejprve ukážeme, že zásady, které upřednostňují informativní aktualizace (tj. ty, které mohou po doručení vést k poklesu AoI), fungují lépe než zásady neinformativní. Potom integrací pokynů, které máme, zvážíme preventivní, informativní zásady založené na AoI a vyhodnotíme jejich výkony pomocí simulací.
A. Informativní zásady
Co se týče API, existují dva typy aktualizací: Informativní aktualizace a neinformativní aktualizace [24]. Informativní aktualizace vedou k poklesu AoI, jakmile jsou doručeny, zatímco neinformativní aktualizace ne. V některých aplikacích, jako jsou autonomní vozidla a kurzy akcií, je rozumné vyřadit neinformativní aktualizace (které nepomáhají snížit AoI, ale mohou blokovat nové aktualizace). V této podsekci představujeme „informativní“ verze různých zásad, které upřednostňují informativní aktualizace a zahazují neinformativní aktualizace. Poté použijeme výsledky simulace, abychom prokázali, že informativní politiky mají obecně lepší průměrný výkon AoI/PAoI než ty původní (neinformativní). Kromě toho důsledně dokazujeme, že ve frontě G/M/1 je informativní verze LCFS stochasticky lepší než původní politika LCFS.
π_I používáme k označení informativní verze3 zásad π. Všechny zásady plánování, které zvažujeme, mají své informativní verze. V některých případech je informativní verze jednoduše stejná jako původní zásada (např. FCFS a LCFS_P).
3 Pro zjednodušení vynecháme v názvu zásady další „_“, pokud je zásada π preventivní zásada končící na „_P“. Například používáme LCFS_PI k označení informativní verze LCFS_P.

Na obr. 11 ukazujeme výsledky simulace průměrného výkonu AoI několika informativních politik ve srovnání s jejich neinformativními protějšky. Pro vyhodnocení přínosu informativních politik vykreslujeme informativní zisk AoI, což je poměr rozdílu mezi průměrným AoI neinformativní verze a informativní verze k průměrnému AoI neinformativní verze. Větší informativní zisk tedy znamená větší užitek z informativní verze. Jedno důležité pozorování z obr. 11 je následující.
Pozorování 8.Informační politiky dosahují lepší průměrné výkonnosti AoI než jejich neinformativní protějšky. Informační zisk je větší u nepreemptivních zásad a zvyšuje se se zvyšujícím se zatížením systému.
Intuitivně se očekává, že informativní zásady překonají své neinformativní protějšky, protože poskytování neinformativních aktualizací nemůže snížit AoI, ale může blokovat nové aktualizace. Výsledky simulace ověřují tuto intuici, protože informativní zisk AoI je vždy nezáporný. Za druhé, můžeme vidět, že většina nepreemptivních politik (např. RANDOM, LCFS a SJF) těží více z upřednostňování informativních aktualizací. Za třetí, jak se zvyšuje zatížení systému ρ, zvyšuje se informativní zisk AoI u většiny zvažovaných politik, zejména u těch nepreemptivních. Je tomu tak proto, že se zvyšujícím se zatížením systému se zvyšuje i počet neinformativních aktualizací, což má větší negativní dopad na výkon AoI u nepreemptivních, neinformativních politik.

Pozorování 8 vede k následujícímu pravidlu:
Pokyn 5. Server by měl upřednostňovat informativní aktualizace a vyřadit neinformativní aktualizace, pokud je to povoleno.
Na základě pozorování 8 se domníváme, že informativní politika je nejméně tak dobrá jako její neinformativní protějšek. Jako předběžný výsledek jsme dokázali, že tato domněnka je skutečně pravdivá pro LCFS ve frontě G/M/1. Dále zavedeme pojem stochastické řazení, který bude použit ve výroku 1.
Definice 2. Stochastické uspořádání stochastických procesů [25, Kap.6.B.7]: Nechť {X(t), t ∈ [0, ∞)} a {Y(t), t ∈ [{ {5}}, ∞)} jsou dva stochastické procesy. Potom {X(t), t ∈ [0, ∞)} je stochasticky menší než {Y(t), t ∈ [0, ∞)}, značeno {X (t), t ∈ [0, ∞)} Menší nebo rovno st{Y(t), t ∈ [0, ∞)}, pokud pro všechny volby celého čísla n a t1 < t2 < · · · < tn v [0, ∞), platí pro všechny horní množiny4 SU ⊆ R n :
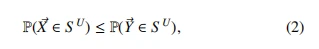
kde X~, (X(ti), X(t2), ···, X(tn)) a Y^, (Y(ti), Y(t2), ···, Y(tn)). Stochastickou rovnost lze definovat podobně a značíme ji {X(t), t ∈ [0, ∞)}=st{Y(t), t ∈ [0, ∞ )}.
Zhruba řečeno, (2) znamená, že X~ s menší pravděpodobností než Y~ nabývá velkých hodnot, kde "velký" znamená jakoukoli hodnotu v horní množině S U. Také používáme ∆π(t) k označení procesu AoI pod politika π. Dále definujeme sadu parametrů I={n, (ti) n i=1 }, kde n je počet aktualizací a ti je doba generování aktualizace i. S těmito definicemi a zápisy jsme nyní připraveni uvést Tvrzení 1.

Tvrzení 1. Ve frontě G/M/1 je pro všechny I, AoI pod LCFS_I stochasticky menší než pod LCFS, tj. Důkaz. Připomeňme, že používáme ti a t I 0 k označení času doručení a času doručení i-té aktualizace. Kromě toho jej používáme k označení času zahájení služby i-té aktualizace.

Stav systému v čase t podle zásady π definujeme jako S π(t), Uπ(t), kde Uπ (t) je největší čas příchodu aktualizací, které byly obslouženy podle zásady π časem t. Nechť {S π(t), t ∈ [0, ∞)} je stavový proces podle zásady π. Podle definice AoI platí (3), pokud platí následující:

Dále dokazujeme (4) kontradikcí pomocí spojovacího argumentu. Předpokládejme, že stochastické procesy ˆS LCFS_I (t) a ˆS LCFS (t) mají stejné stochastické zákony jako S LCFS_I (t) a S LCFS (t). Spojujeme ˆS LCFS_I (t) a ˆS LCFS (t) následujícím způsobem: Pokud je aktualizace i doručena v t I 0 v ˆS LCFS(t), pak je aktualizace j doručeno v t I 0 (pokud existuje) v ˆS LCFS_I(t) je také doručeno ve stejnou dobu. Toto spojení je rozumné, protože: (i) aktualizace poskytované v ˆS LCFS_I(t) nejsou vybírány na základě velikosti aktualizace; (ii) servisní čas aktualizace v ˆS LCFS_I (t) a ˆS LCFS (t) je exponenciálně distribuován a má vlastnost bez paměti. Věta 6.B.30 v [25], (4) platí, pokud platí následující:

V následujícím chceme ukázat, že ˆS LCFS{{0}}I (t) Větší nebo rovno ˆS LCFS (t) platí podmíněně na libovolné dráze vzorku I, což triviálně implikuje (5). Dokazujeme to kontradikcí. V zájmu rozporu předpokládejme, že ˆS LCFS_I(t) < ˆS LCFS(t) se skutečně stane a že se tak stane poprvé v čase t0 (ilustraci viz obr. 13 ). Nechť m a n je index obsluhovaných aktualizací s největším časem příchodu o t0 v ˆS LCFS_I(t) a ˆS LCFS(t). Pak máme ULCFS_I(t{{10}})=tm a ULCFS(t0)=tn. Všimněte si, že máme také tm < tn kvůli ˆS LCFS_I(t0) < ˆS LCFS(t0) (tj. ULCFS_I(t{ {18}}) < ULCFS(t{{20}})). Protože t0 je poprvé, kdy dojde k ˆS LCFS_I(t) < ˆS LCFS(t), zásadním postřehem je, že t0 musí být ihned po doručení aktualizace v ˆS LCFS(t). Máme tedy t0=(t 0n) plus , kde (t 0n) plus označuje čas bezprostředně po t 0n .
Kvůli vazbě mezi ˆS LCFS(t) a ˆS LCFS{{0}}I(t) existují dva případy v ˆS LCFS_I(t): 1) Server probíhá nečinný při t 0n; 2) aktualizace je doručena také v t 0n. Tyto dva případy probíráme odděleně a ukazujeme, že v obou případech existuje rozpor.
Případ 1: Server v ˆS LCFS_I(t) je nečinný při t 0n (viz obr. 13(a)). Poté musí být poslední dodaná aktualizace v ˆS LCFS_I(t) (tj. m-tá aktualizace) doručena před t 0n. Máme tedy t 0m < t 0n a server v ˆS LCFS_I(t) zůstává v klidovém stavu po dobu (t 0m, t {{10}}n ]. Pak by server v ˆS LCFS_I(t) mohl začít poskytovat novější aktualizaci, která dorazí později než měsíční aktualizace ihned po t 0m. ( Taková novější aktualizace musí existovat, protože n-tá aktualizace je platným kandidátem kvůli tm < tn.) To má za následek rozpor s nečinností serveru během (t'm, t'n ].

Případ 2): Aktualizace je doručena v t 0n v ˆS LCFS_I(t). Tato doručená aktualizace je měsíční aktualizací. Všimněte si, že musíme mít sm < tn. Je to proto, že pokud je sm větší nebo rovno tn, pak by se server v ˆS LCFS_I(t) rozhodl poskytovat n-tou aktualizaci nebo novější aktualizaci, která dorazí později než tn v čase sm od této volby aktualizace je novější (kvůli tm < tn). V ˆS LCFS(t) jsou v čase sm pro server dva podpřípady: 2a) Nečinný; 2b) zaneprázdněn. Znovu probíráme tyto dva podpřípady odděleně a ukazujeme, že v obou případech existuje rozpor.
Případ 2a: Server v ˆS LCFS(t) je nečinný v čase sm (viz obr. 13(b)). V tomto případě musí být m-tá aktualizace již doručena časem sm v ˆS LCFS(t). Jinak by server v ˆS LCFS(t) začal obsluhovat m-tou aktualizaci (nebo novější aktualizaci) v nebo před sm. To znamená, že ˆS LCFS_I(t) < ˆS LCFS(t) nastane před sm, což má za následek rozpor s tím, že t0 je poprvé, kdy ˆS LCFS_ I(t) < ˆS LCFS(t) nastane.
Případ 2b): Server v ˆS LCFS(t) je zaneprázdněn v čase sm (viz obr. 13(c)). Předpokládejme, že 1. aktualizace je obsluhována na sm v ˆS LCFS(t). V tomto případě musí být l-tá aktualizace doručena časem sn v ˆS LCFS(t). Je to proto, že n-tá aktualizace zahájí službu v sn v ˆS LCFS(t). Poté musí být m-tá aktualizace doručena také časem sn v ˆS LCFS_I(t), kvůli vazbě mezi ˆS LCFS(t) a ˆS LCFS_I(t). To má za následek rozpor, že měsíční aktualizace je dodávána v deset.
Kombinací všech případů ukážeme, že ˆS LCFS_I (t) Větší nebo rovno ˆS LCFS (t) platí podmíněně na libovolné dráze vzorku I. To triviálně implikuje (5), což dále implikuje (4 ) větou 6.B.30 v [25]. Tím je důkaz dokončen.
B. Preemptivní, informativní zásady založené na AoI
Doposud jsme demonstrovali výhody preemptivních politik, politik založených na AoI a informativních politik. V této podsekci chceme integrovat všechny tyto tři myšlenky a navrhnout preventivní, informativní politiku založenou na AoI.
Nejprve zvažujeme preventivní, informativní verzi tří zásad založených na AoI: ADE_PI, ADS_PI a ADM_PI. Zajímavé je, že můžeme ukázat ekvivalenci mezi ADE_PI a SRPT_I (tj. informativní verze SRPT) a mezi ADE_I a SJF_I (tj. , informativní verze ADE a SJF, v tomto pořadí) ve smyslu vzorové cesty. Tyto výsledky jsou uvedeny v návrzích 2 a 3.
Návrh 2.ADE_PI a SRPT_I jsou ekvivalentní v každé vzorové cestě.
Důkaz. Silnou indukcí dokazujeme, že v rámci stejné vzorové cesty, ADE_PI a SRPT_vyberu vždy stejnou aktualizaci, která se zobrazí ve stejnou dobu. V následujícím textu bereme v úvahu pouze informativní aktualizace, protože neinformativní aktualizace jsou vyřazeny v rámci ADE_PI i SRPT_I.

Předpokládejme, že když ADE_PI potřebuje vybrat n-tou aktualizaci k poskytování v čase tADE_PI (n), vybere aktualizaci s indexem dADE_PI (n). Podobně SRPT_I zvolí aktualizaci s indexem dSRPT_I (n) jako svou n-tou aktualizaci, která bude sloužit na tSRPT_I (n).
Nárok: ADE_PI a SRPT_Vždy poskytuji stejnou aktualizaci ve stejnou dobu, tj. (dADE_PI(n), tADE_PI(n ))=(dSRPT_I(n), tSRPT_I(n)) pro všechna n.
Základní případ: Když n=1, ADE_PI i SRPT_poskytuji první aktualizaci, když dorazí. Máme tedy (dADE_PI(1), tADE_PI(1))=(dSRPT_I(1), tSRPT_ I(1)).
Indukční krok: Předpokládejme, že pro n=k (k větší nebo rovno 1) máme (dADE_PI(m), tADE_PI(m)) {{ 4}} (dSRPT_I(m), tSRPT_I(m)) pro m-tou aktualizaci pro všechny 1 Menší nebo rovno m Menší než nebo rovno k. Chceme ukázat, že (dADE_PI(n), tADE_PI(n))=(dSRPT_I(n), tSRPT{{12} }I(n)) stále platí pro n=k plus 1. Všimněte si, že existují dva případy pro (k plus 1) aktualizaci: 1) (k plus 1) aktualizace zabrání k-té aktualizaci; 2) (k plus 1) aktualizace nepředjímá k-tou aktualizaci, tj. (k plus 1) aktualizace spustí službu z klidového stavu nebo ihned po doručení k-té aktualizace. Tyto dva případy diskutujeme samostatně a ukazujeme, že (dADE−PI(k plus 1), tADE−PI(k plus 1))=(dSRPT_I(k plus 1), tSRPT{{ 26}}I(k plus 1)) platí v obou případech.
Případ 1: (k plus 1) první aktualizace zabrání k-té aktualizaci. Během služby k-té aktualizace přichází (k plus 1) aktualizace. V ADE_PI, aby AoI klesl co nejdříve, server porovná zbývající dobu služby k-té aktualizace s původní dobou služby (k plus 1) aktualizace a rozhodne se poskytnout aktualizaci s kratší zbývající servisní čas. Je to stejné, jako dělám SRPT_. Máme tedy (dADE−PI(k plus 1), tADE−PI(k plus 1))=(dSRPT_I(k plus 1), tSRPT_I( k plus 1))
Případ 2: (k plus 1) aktualizace nepředjímá k-tou aktualizaci. Na jedné straně, pokud (k plus 1) aktualizace zahájí službu z klidového stavu, pak podle indukční hypotézy ADE_PI i SRPT_ dokončím poskytování k-té aktualizace v ve stejnou dobu a poté projít obdobím nečinnosti. Proto ADE_PI a SRPT_budu také poskytovat stejnou (k plus 1) aktualizaci ve stejnou dobu, tj. (dADE−PI(k plus 1), tADE−PI( k plus 1))=(dSRPT_I(k plus 1), tSRPT_I(k plus 1)). Na druhou stranu, pokud (k plus 1) aktualizace spustí službu ihned po službě k-té aktualizace, pak podle indukční hypotézy, ADE_PI a SRPT_začnu službu v ve stejnou dobu, tj. tADE_PI (k plus 1) =tSRPT_I (k plus 1). SRPT_Vyberu (k plus 1) aktualizaci s nejkratší zbývající velikostí. Tato vybraná (k plus 1) aktualizace však nemusela být doručena dříve. V opačném případě tato aktualizace již nemá informativní charakter, byla převzata jinou aktualizací. Takže SRPT_Skončil jsem výběrem aktualizace s nejkratší původní velikostí, kterou také vybere ADE_PI. To znamená dADE_PI (k plus 1)=dSRPT_I (k plus 1). Máme tedy (dADE−PI(k plus 1), tADE−PI(k plus 1))=(dSRPT_I(k plus 1), tSRPT_I( k plus 1)).

Návrh 3.ADE_I a SJF_I jsou ekvivalentní v každé vzorové cestě.
Důkaz. Podobně jako u důkazu Proposition 2 používáme silnou indukci, abychom ukázali, že v rámci stejné vzorové cesty, ADE_Já a SJF_vždy volím stejnou aktualizaci, která se má zobrazovat ve stejnou dobu. Zde také bereme v úvahu pouze informativní aktualizace.
Předpokládejme, že když ADE_I potřebuje vybrat n-tou aktualizaci k poskytování v čase tADE_I (n), vybere aktualizaci s indexem dADE_I (n). Podobně SJF_I zvolí aktualizaci s indexem dSJF_I (n) jako svou n-tou aktualizaci, která bude sloužit na tSJF_I(n).
Nárok: ADE_I a SJF_Vždy poskytuji stejnou aktualizaci ve stejnou dobu, tj. (dADE−I(n), tADE−I(n))=( dSJF−I(n), tSJF−I(n)) pro všechna n.
Základní případ: Když n=1, ADE_I i SJF_I poskytnou první aktualizaci, když dorazí. Máme tedy (dADE−I(1), tADE−I(1))=(dSJF−I(1), tSJF−I(1)).
Indukční krok: Předpokládejme, že pro n=k (k větší nebo rovno 1) máme dADE−I(m), tADE−I(m))=(dSJF−I(m ), tSJF−I(m)). pro m-tou aktualizaci pro 1 Menší nebo rovno m Menší než nebo rovno k. Chceme ukázat, že dADE−I(n), tADE−I(n))=(dSJF−I(n), tSJF−I(n)) stále platí pro n=k plus 1. Všimněte si, že existují dva případy (k plus 1) aktualizace: 1) (k plus 1) aktualizace spustí službu z klidového stavu; 2) (k plus 1) aktualizace zahájí službu ihned po doručení k-té aktualizace. Tyto dva případy diskutujeme samostatně a ukazujeme, že dADE−I(k plus 1), tADE−I(k plus 1))=(dSJF−I(k plus 1), tSJF−I(k plus 1) ) platí v obou případech.
Případ 1: (k plus 1) první aktualizace spustí službu z klidového stavu. Podle indukční hypotézy ADE_I a SJF_dokončím poskytování k-té aktualizace ve stejnou dobu a poté procházím obdobím nečinnosti. Proto ADE_I a SJF_I budu také poskytovat stejnou (k plus 1) aktualizaci ve stejnou dobu, tj. dADE−I(k plus 1), tADE−I(k plus 1))=(dSJF−I(k plus 1), tSJF−I(k plus 1)).
Případ 2: (k plus 1) aktualizace zahájí službu ihned po doručení k-té aktualizace. Podle indukční hypotézy zahájím službu ADE_I a SJF_ve stejnou dobu, tj. tADE_I (k plus 1) =tSJF{{ 7}}I (k plus 1). SJF_Vyberu (k plus 1) aktualizaci, která má nejmenší velikost aktualizace, kterou také vybere ADE_I, protože tato aktualizace může způsobit, že AoI klesne nejdříve. To znamená dADE_PI (k plus 1)=dSJF_I (k plus 1). Máme tedy dADE−I(k plus 1), tADE−I(k plus 1))=(dSJF−I(k plus 1), tSJF−I(k plus 1)).

Tvrzení 2 a 3 naznačují, že ačkoli SRPT_I a SJF_výslovně nesleduji návrh založený na AoI, jsou to v podstatě zásady založené na AoI. To poskytuje intuitivní vysvětlení, proč politiky založené na velikosti, jako jsou varianty SRPT a SJF, mají dobrý empirický výkon AoI.
Na obr. 14 uvádíme výsledky simulace pro průměrný výkon AoI preemptivních, informativních zásad založených na AoI (ADE_PI) ve srovnání s několika jinými politikami. Pozorujeme, že v různých nastaveních, která zvažujeme, dosahuje ADE_PI nejlepšího výkonu AoI. Nicméně ve srovnání s nejlepšími politikami s efektivním zpožděním (jako je SRPT) je zlepšení AoI u preventivních, informativních politik a politik založených na AoI spíše marginální v prostředí s exogenními příchody.
VII. ZÁVĚR
V tomto článku jsme systematicky studovali dopad různých aspektů plánovacích politik na výkon AoI a poskytli jsme několik užitečných pokynů pro návrh AoI efektivních plánovacích politik. Naše studie odhaluje, že mezi různými aspekty plánovacích politik, které jsme zkoumali, hraje nejdůležitější roli při navrhování efektivních plánovacích politik upřednostňování malých aktualizací, umožnění preempce služeb a upřednostňování informativních aktualizací. Ukazuje se, že běžné zásady plánování, jako je SRPT a SJF_P, a jejich informativní varianty mohou dosáhnout velmi dobrého výkonu AoI, i když explicitně nečiní rozhodnutí o plánování na základě AoI. To lze částečně vysvětlit ekvivalencí mezi takovými politikami založenými na velikosti a některými politikami založenými na AoI. Navíc, když požadavek AoI není přísný nebo informace o velikosti aktualizace nejsou k dispozici, jsou dobrými kandidáty na zásady efektivní AoI i některé jednoduché zásady účinné pro zpoždění (například LCFS{6}}P).
Naše zjištění také vyvolávají několik zajímavých otázek, které stojí za to prozkoumat jako budoucí práci. Jedním z důležitých směrů je sledovat více teoretických výsledků nad rámec výsledků simulací, které jsme poskytli v tomto článku. Bylo by například zajímavé zjistit, zda lze důsledně dokázat, že jakákoli informativní politika vždy překonává její neinformativní protějšek, což je ve výsledcích simulace konzistentně pozorováno.
PŘÍLOHA A DALŠÍ VÝSLEDKY SIMULACE PRO FRONTU G/G/1
Uvádíme další výsledky simulace pro frontu G/G/1 na Obr. 16–23. U všech těchto simulací předpokládáme, že čas mezi příchodem sleduje Weibullovu distribuci s C 2=10. Na podobrázku (a) předpokládáme, že velikost aktualizace sleduje exponenciální rozdělení se střední hodnotou 1/µ=1; v podobrázcích (b) a (c) předpokládáme, že velikost aktualizace sleduje Weibullovu distribuci se střední hodnotou 1/µ=1. Všimněte si, že v podobrázcích (a) a (b) měníme hodnotu zatížení systému ρ; na podobrázku (c) změníme hodnotu C 2 pro velikost aktualizace, přičemž zatížení systému zafixujeme na ρ=0.7. Pozorování 1–8 lze také provést pro nastavení fronty G/G/1.
REFERENCE
[1] Z. Liu, L. Huang, B. Li a B. Ji, "Plánování proti stárnutí ve frontách na jednom serveru: Systematická a srovnávací studie," v Proc. INFOCOM WKSHPS, 2020.
[2] S. Kaul, R. Yates a M. Gruteser, "Stav v reálném čase: Jak často by se měl aktualizovat?" v Proc. IEEE INFOCOM, 2012.
[3] S. Wu, X. Ren, S. Dey a L. Shi, "Optimální plánování více senzorů s omezením délky paketů", IFAC-PapersOnLine, sv. 50, č. 1, str. 14 430–14 435, červenec 2017.
[4] M. Harchol-Balter, Performance modeling and design of computer systems: Queuing theory in action. Cambridge University Press, 2013.
[5] AM Bedewy, Y. Sun a NB Shroff, „Optimalizace čerstvosti dat, propustnosti a zpoždění v systémech aktualizace informací na více serverech“, v Proc. IEEE ISIT, 2016.
[6] M. Costa, M. Codreanu a A. Ephremides, "Věk informací se správou paketů", v Proc. IEEE ISIT, 2014.
[7] N. Pappas, J. Gunnarsson, L. Kratz, M. Kountouris a V. Angelakis, "Věk informací z více zdrojů s řízením front", v Proc. IEEE ICC, 2015.
[8] ME Crovella, R. Frangioso a M. Harchol-Balter, "Plánování připojení na webových serverech", Boston University Computer Science Department, Tech. Rep., 1999.
[9] L. Schrage, "Důkaz optimality disciplíny s nejkratším zbývajícím časem zpracování," Operations Research, sv. 16, č. 3, s. 687–690, 1968.
[10] DR Smith, "Nový důkaz optimality disciplíny s nejkratším zbývajícím časem zpracování," Operations Research, sv. 26, č. 1, s. 197–199, 1978.
[11] M. Harchol-Balter, "Queueing disciplíny," Wiley Encyclopedia of Operations Research and Management Science, 2010.
[12] A. Kosta, N. Pappas a V. Angelakis, Age of Information: A New Concept, Metric, and Tool, 2017.
[13] Y. Sun, I. Kadota, R. Talak a E. Modiano, Age of Information: A New Metric for Information Freshness, 2019.
[14] M. Costa, M. Codreanu a A. Ephremides, "O věku informací v systémech aktualizace stavu se správou paketů," IEEE Trans. Inf. Teorie, sv. 62, č.p. 4, s. 1897–1910, duben 2016.
[15] M. Moltafet, M. Leinonen a M. Codreanu, „O věku informací ve vícezdrojových modelech front“, IEEE Trans. Commun., sv. 68, č.p. 8, s. 5003–5017, květen 2020.
[16] SK Kaul, RD Yates a M. Gruteser, "Aktualizace stavu prostřednictvím front", v Proc. CISS, 2012.
[17] C. Kam, S. Kompella a A. Ephremides, "Vliv rozmanitosti přenosu zpráv na věk statusu", v Proc. IEEE ISIT, 2014, s. 2411–2415.
[18] E. Najm a E. Telatar, „Aktualizace stavu v preemptivní frontě s více proudy m/g/1/1“, v IEEE INFOCOM WKSHPS, 2018.
[19] Y. Inoue, H. Masuyama, T. Takine a T. Tanaka, „Obecný vzorec pro stacionární distribuci věku informací a jeho aplikace na fronty na jednom serveru“, arXiv preprint arXiv:1804.06139, 2018 .
[20] R. Talak a E. Modiano, „Věkové kompromisy v systémech s jedním serverem“, arXiv preprint arXiv:1901.04167, 2019.
[21] R. Devassy, G. Durisi, GC Ferrante, O. Simeone a E. UysalBiyikoglu, "Pravděpodobnost narušení zpoždění a vrcholného věku u přenosů krátkých paketů", v Proc. IEEE ISIT, 2018.
[22] Z. Liu, L. Huang, B. Li a B. Ji, „Plánování proti stárnutí ve frontách na jednom serveru: Systematická a srovnávací studie“, arXiv e-prints, str. arXiv:2003.04271, říjen 2020.
[23] RD Yates a SK Kaul, "Věk informací: Aktualizace stavu v reálném čase z více zdrojů," IEEE Trans. Inf. Teorie, sv. 65, č.p. 3, s. 1807–1827, březen 2019.
[24] C. Kam, S. Kompella a A. Ephremides, "Věk informací při náhodných aktualizacích", v Proc. IEEE ISIT, 2013.
[25] M. Shaked a JG Shanthikumar, Stochastické řády. Springer Science & Business Media, 2007.


【Další informace:george.deng@wecistanche.com / WhatApp:{0}}】