Výzvy a příležitosti s kauzálními objevovacími algoritmy: Aplikace na Alzheimerovu patofyziologii
Feb 19, 2022
Xinpeng Shen1*, Sisi Ma1a kol
Causal Structure Discovery (cSD) je problém identifikace kauzálních vztahů z velkého množství dat pomocí výpočetních metod. S omezenou schopností tradičních výpočetních metod založených na asociacích odhalit kauzální vztahy, získávají metodologie cSD na popularitě. Cílem studie bylo systematicky zkoumat, zda (i) metody cSD mohou odhalit známé kauzální vztahy z observačních klinických dat a (ii) nabídnout návod k přesnému odhalení známých kauzálních vztahů. Použili jsmeAlzheimerova choroba(AD), komplexní progresivní onemocnění, jako model, protože dobře zavedené důkazy poskytují „zlatý standard“ kauzální graf pro hodnocení. Hodnotili jsme dvě metody cSD, rychlou kauzální inferenci (FCI) a rychlé vyhledávání ekvivalence Greedy (fGeS), pokud jde o jejich schopnost objevit tuto strukturu z dat shromážděnýchAlzheimerova chorobainiciativa neuroimaging (ADni). Jako kontrolu jsme použili modely strukturních rovnic (které nejsou navrženy pro cSD). Tyto metody jsme aplikovali ve třech scénářích definovaných rostoucím množstvím základních znalostí poskytovaných k metodám. metody byly hodnoceny porovnáním výsledných kauzálních vztahů s grafem „zlatého standardu“, který byl zkonstruován z literatury. Specializovaným metodám cSD se podařilo objevit grafy, které se téměř shodovaly se zlatým standardem. pro nejlepší výsledky by měly být použity algoritmy cSD s longitudinálními daty poskytujícími co nejvíce předchozích znalostí.
Kontakt:joanna.jia@wecistanche.com/ WhatsApp: 008618081934791

Účinekextrakt z cistanchefenoxyethanolové glykosidy naAlzheimerova choroba
Analytika velkých dat, strojové učení a hluboké učení vzbudily značný zájem o obory zdravovědy1,2. Díky své vynikající prediktivní přesnosti se stále častěji používají pro diagnostiku onemocnění a predikci rizik3. V mnoha biomedicínských aplikacích však dosažení vysoké přesnosti předpovědi samo o sobě není primárním cílem; odhalení rizikového faktoru nebo mechanismu, který lze změnit, je často primární výzkumnou otázkou.
Dnešní aplikace strojového učení jsou z velké části založeny na asociacích. I když může být s onemocněním spojen rizikový faktor, nemusí to nutně znamenat, že může změnit proces onemocnění. Na začátku roku 2018 test fáze 3 s názvem „TOMORROW“ testoval účinek léku na cukrovku na sníženíAlzheimerova choroba(AD) riziko demence4. Studie měřila ukládání amyloidu, které je časným příznakem Alzheimerovy choroby a je také spojeno s cukrovkou. Protože však diabetes není příčinou amyloidózy, studie selhala v prozatímní analýze5,6. Pro úspěšnou intervenci by měl mít rizikový faktor, do kterého zasahujeme, kauzální (spíše než pouze asociativní) vztah schorobavýsledek.
Klinický výzkum je převážně zaměřen na kauzální vztahy. Hypotézou řízený klinický výzkum například často předpokládá kauzální strukturu, soubor kauzálních vztahů mezi biomarkery a výsledky a výzkumníci odhadují velikost účinku těchto vztahů (např. kauzální inference). V takovém výzkumu je vyvození kauzálního závěru platné, protože předchozí znalosti zjišťují, že vztahy jsou skutečně kauzální. Pokud však neexistuje žádná znalost kauzality, je třeba z dat zjistit samotnou kauzální strukturu pomocí procesu známého jako objev kauzální struktury. Běžně používanou, ale nesprávnou praxí je předpokládat částečnou kauzální strukturu a upravit ji na základě výstupních statistik přizpůsobeného modelu pomocí metod, jako jsou modely strukturních rovnic (SEM).
V této práci, s použitím biomarkerů AD jako prediktorů a kognice jako výsledku, jsme se rozhodli určit optimální způsob, jak objevit kauzální vztahy. Jako model pro tento problém jsme použili AD, protože kaskáda biomarkerů AD je dobře pochopena7 a kauzální vztahy mezi primárními prediktory byly také dobře charakterizovány, takže lze sestavit graf „zlatého standardu“. Dále veřejný soubor datAlzheimerova choroba← Iniciativa neuroimagingu (ADNI) má k dispozici rozsáhlé longitudinální údaje, které napomáhají systematickým srovnáním plánovaným v tomto rukopisu. Zde se zaměřujeme na porovnání výsledků ze specializovaných kauzálních vyhledávacích algoritmů a vyhledávacího algoritmu založeného na SEM s naším grafem „zlatého standardu“. Zkoumali jsme také příčinu běžných chyb a prozkoumali jsme metody, jak jim předcházet. Tyto experimenty nám umožnily poskytnout pokyny pro objevování kauzálních struktur pomocí pozorovacích dat.
Cistanche zabraňujeAlzheimerova choroba
Pozadí
algoritmy odhalování kauzální struktury.Neformálně je příčinná souvislost definována jako vztah mezi dvěma proměnnými X a Y tak, že změny X vedou ke změnám Y8. Klíčový rozdíl mezi asociací a kauzalitou spočívá v potenciálu matení. Předpokládejme, že mezi X a Y neexistuje žádný přímý kauzální vztah, ale spíše třetí proměnná Z způsobuje X i Y. V tomto případě, i když jsou X a Y silně spojeny, změna X nepovede ke změnám v Y. Z se nazývá a matoucí. Více formálně, příčinná souvislost je přímý účinek mezi A a B, který zůstane po úpravě pro zmatek. Zmatení může být pozorováno nebo nepozorováno (latentní).
Kauzální struktura je soubor kauzálních vztahů mezi souborem proměnných a objev kauzální struktury je problém naučit se kauzální strukturu z pozorovaných dat. Vyhrazené algoritmy zjišťování kauzální struktury existují a lze je rozdělit do dvou podtypů, na omezení a na skóre. Algoritmy založené na omezení konstruují kauzální strukturu založenou na omezeních podmíněné nezávislosti, zatímco algoritmy založené na skóre generují řadu kandidátských kauzálních grafů, každému přiřazují skóre a na základě skóre vybírají konečný graf. V této studii jsme vybrali jeden významný algoritmus z každého typu: Fast Causal Inference Algorithm (FCI), což je algoritmus založený na omezeních, a Fast Greedy Equivalence Search (FGES), což je algoritmus založený na skóre. Pro stručnost uvádíme popis na vysoké úrovni pro FGES a FCI. Pro podrobnější popis odkazujeme čtenáře na odkazy9–11. Obě dvě metody se mohou přizpůsobit pozorovanému zmatení a jeden z algoritmů, FCI, má určitou schopnost objevit latentní zmatení.
rychlá kauzální inference (fci).Ústředním konceptem algoritmu kauzálního objevování založeného na omezeních je myšlenka, že různé kauzální struktury implikují různé vztahy nezávislosti. Například kauzální vztah A→- B →C implikuje, že proměnná A je nezávislá na C vzhledem k B. Na druhou stranu, když A →C←B, A a B jsou nezávislé (bezpodmínečně), ale stávají se závislými podmíněnými na C. Tato druhá struktura se nazývá "V" struktura (také známá jako collider), která má jedinečný vztah nezávislosti ve srovnání s jinými kauzálními vztahy. Ve skutečnosti je to jedno z „primitivů“, které algoritmus založený na omezeních, jako je FCI, hledá.
Charakteristickým rysem FCI i mezi metodami založenými na omezení je jeho schopnost odhalit latentní (nepozorované) zmatky. To umožňuje další primitivum, struktura "Y". Čtyři proměnné definují strukturu "Y", když mají následující kauzální vztahy: W1 →X ← W2 a X →Y. V rámci struktury „Y“ jsou W1 i W2 nezávislé na Y podmíněné X. Tato podmíněná nezávislost pomáhá vyloučit možnost neměřeného zmatení mezi X a Y. Jinými slovy, když FCI najde strukturu „Y“ ve graf, kauzální vztah od X k Y je zaručeně nepodložený; jinak FCI předpokládá, že existují možná nepozorované zmatky12.
Algoritmus rychlé kauzální inference (FCI). FCI konstruuje kauzální graf počínaje plně propojeným neorientovaným grafem a odstraňuje hrany, které spojují podmíněně nezávislé proměnné. Ve druhé fázi orientuje hrany identifikací struktur „V“ a „Y“ a pokouší se orientovat zbývající hrany na základě sady pravidel, která byla podrobně vysvětlena jinde9,13.
Algoritmus rychlého vyhledávání greedy ekvivalence (FGES).Algoritmus Greedy Equivalence Search (GES) má také dvě fáze. První fáze začíná grafem, který neobsahuje žádné hrany (což odpovídá tomu, že všechny proměnné jsou na sobě nezávislé) a nenasytně přidává hrany (závislosti) jednu po druhé v orientaci, která minimalizuje Bayesovo informační skóre14 (BIC), které je pravděpodobně penalizováno za složitost pro snížení nadměrného vybavení. GES pak odstraňuje hrany jednu po druhé, dokud snižuje BIC. Algoritmus FGES10 použitý v této práci je prostě "rychlá" (paralelní) verze GES11,15. Podobně jako FCI, FGES také spoléhá na "V" struktury pro orientaci hran. Implikovaná pravděpodobnost struktury "V" je jedinečná, zatímco pravděpodobnosti A →B →C, C →B →A a A ←BC jsou stejné. Tus, FGES vybere struktury "V", pokud to znamená vyšší pravděpodobnost než jiné struktury.
Modelování strukturních rovnic (SEM).Structural Equation Modeling (SEM) je skupina statistických modelů, které vzhledem k základní kauzální struktuře mohou odhadnout velikost účinku (a také další statistiky) každého vztahu16. SEM může také navrhnout úpravy dané kauzální struktury pro zlepšení statistiky přizpůsobení modelu.
I když SEM nebyl navržen tak, aby objevil kauzální strukturu, není neobvyklé používat navrhované modifikace SEM k „upřesnění“ struktury grafu. Tuto funkci lze využít k iterativnímu vytvoření kauzálního grafu v každé iteraci přidáním jedné hrany podle návrhu SEM. Tuto (nesprávnou) vyhledávací metodu jsme implementovali ve dvou scénářích: (1) počínaje prázdným grafem (kauzální objev); a (2) počínaje grafem získaným odstraněním 1 nebo 2 hran z grafu "zlatého standardu". Všimněte si, že v rámci tohoto článku používáme termín "SEM" k reprezentaci algoritmu, který používá SEM k provádění vyhledávání hran, nikoli k odhadu velikosti efektu.
Klíčové rozdíly mezi algoritmy. SEM i FGES jsou postupné algoritmy, které upravují strukturu přidáním nebo odstraněním hran. Největší výhodou FGES je, že rozšiřuje vyhledávací prostor transformací aktuální struktury na jiné „ekvivalentní“ struktury. Například při dané hraně je A →B v grafech A, B a C. SEM se pokusí přidat jednu směrovanou hranu mezi C a A nebo C a B, což dává čtyři možnosti. FGES však zvažuje více možností, protože může také obrátit stávající hranu A →B na A ←B, čímž získá čtyři další možné struktury.
Kromě vyhledávacích strategií (na základě omezení versus skóre) se FCI také liší od ostatních dvou algoritmů ve svém předpokladu o příčinné souvislosti: SEM i FGES fungují za předpokladu, že neexistují žádné neměřené zmatky. Jinými slovy, všechny matoucí proměnné jsou měřeny v souboru dat. FCI však tento předpoklad uvolňuje a hlásí nepodložený vztah pouze tehdy, když narazí na strukturu „Y“17.
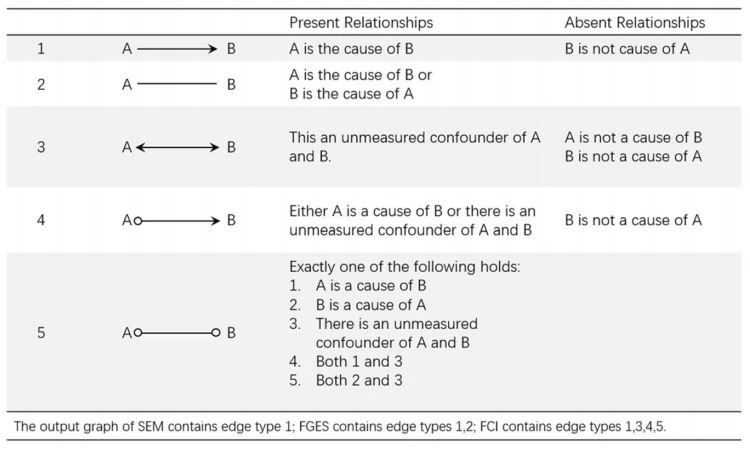
Algoritmy FCI a FGES jsou implementovány v softwarovém balíku Tetrad (verze 6.5.4). Obrázek 1 ukazuje interpretace různých typů hran ve výstupním grafu. Pro SEM jsme použili balíček R 'lavaan'18.
Metoda
Data.Data použitá při přípravě tohoto článku byla získána zAlzheimerova chorobaDatabáze Neuroimaging Initiative (ADNI) (adni.loni.usc.edu). ADNI byla zahájena v roce 2003 jako partnerství veřejného a soukromého sektoru pod vedením hlavního řešitele Michaela W. Weinera, MD. Primárním cílem ADNI bylo otestovat, zda je možné kombinovat sériové zobrazování magnetickou rezonancí (MRI), pozitronovou emisní tomografii (PET), další biologické markery a klinické a neuropsychologické hodnocení k měření progrese mírné kognitivní poruchy (MCI) a časnéAlzheimerova chorobachoroba(AD)19. Studie ADNI má tři fáze, z nichž poslední, ADNI3, stále probíhá. Všichni účastníci studie poskytli písemný informovaný souhlas a protokoly studie byly schváleny institucionálním kontrolním výborem každého místního pracoviště. Všechny metody byly provedeny v souladu s příslušnými směrnicemi a předpisy. Aktuální informace naleznete na www.adni-info.org. Kontrola IRB nebyla vyžadována, protože data ADNI jsou deidentifikována a jsou veřejně dostupná ke stažení. Naši studii jsme zaměřili na první dva: ADNI 1 a ADNI 2/GO. Proměnné extrahované z dat jsou fludeoxyglukóza PET (FDG), amyloid-beta (ABETA), fosforylovaný tau (PTAU), alela apolipoproteinu E (APOE) ε4; demografické informace: věk, pohlaví, vzdělání (EDU); a diagnostika na AD (DX). Tabulka 1 uvádí souhrnné statistiky souboru dat. Po odstranění záznamů s chybějícími hodnotami zbývá 1008 účastníků s alespoň jedním úplným záznamem a 266 s pravidelnou dvouletou následnou návštěvou.
grafu „zlatého standardu“.Kaskáda biomarkerů AD byla široce hodnocena. Ukládání ABETA v mozku je časnou událostí v procesu onemocnění a je zachyceno snížením ABETA v CSF. Ukázané rizikové faktory pro ABETA jsou věk a počet alel APOE46,20,21. ABETA způsobuje downstream tvorbu neurofibrilárních spletenců a následně neurodegeneraci, které jsou oba zachyceny metabolickou dysfunkcí prostřednictvím FDG-PET22 a zvýšením PTAU měřeným na CSF23. Dva markery FDG-PET a CSF PTAU jsou nejsilnějšími prediktory kognitivní dysfunkce nebo diagnózy24,25 (ve srovnání s ABETA). Vzdělání, náhrada kognitivní odolnosti, ovlivňuje kognitivní stav jedince26. To vše jsou v literatuře dobře zavedené vztahy. Některé z těchto asociací ovlivňují slabší kauzální asociace, jako je pohlaví, které jsme nebrali v úvahu při hodnocení algoritmů, protože dopad těchto asociací je mnohem menší ve srovnání s hlavními efekty uvažovanými v grafu „zlatého standardu“. Výše popsané vztahy jsou na obr. 2. Obr.
Základní znalosti a průřezová vs longitudinální data.Pro omezení vztahů, které mohou algoritmy objevit, mohou být poskytnuty základní znalosti ve formě hran, které musíte mít nebo nesmíte mít (zakázané). V tomto článku jsme definovali tři stupně základních znalostí jako: (Úroveň 1) Žádné znalosti: objevená struktura čistě odráží data; žádné hrany nejsou zakázány. (Úroveň 2) Triviální základní znalosti: (a) okraje mezi demografickými proměnnými jsou zakázány (ačkoli spojitost mezi nimi může zůstat) (b) okraje od biomarkerů nebo diagnózy k demografickým proměnným jsou zakázány. (Úroveň 3)

Studovat design.Studie kauzálního objevu. Pro tuto část studie jsme z ANDI extrahovali dva soubory dat: jeden byl jednoprůřezový a data byla shromážděna při základní návštěvě každého účastníka. Druhý je longitudinální, kde jsme zahrnuli data ze dvou průřezů: vstupní návštěvy a návštěvy provedené po 24 měsících. Záznamy s chybějícími údaji byly z další studie odstraněny.
Pro získání robustních výsledků byla jak průřezová, tak podélná data bootstrapována 100krát na úrovni účastníka. Tři algoritmy, SEM, FCI a FGES, byly testovány na všech vzorcích bootstrapu za účelem vyhodnocení, přičemž byly zahrnuty tři různé stupně znalostí, které byly popsány v předchozí části.

SEM-studie obnovy. Protože většina výzkumníků začne s předpokládaným grafem a použije SEM pouze k přidání hran, testovali jsme také SEM v tomto předpokládaném případě použití: inicializovali jsme (hypotezované) grafy odstraněním každé jednotlivé hrany a každého páru hran z grafu „zlatého standardu“. a poté otestovali, zda SEM dokáže obnovit odstraněné hrany po maximálně pěti iteracích přidávání hran. V této studii jsme vybrali pět, protože více než pětinásobné přidání hran povede ke grafu s nízkou vybavitelností.
vyhodnocovací metriky. Pro posouzení výkonnosti metod jsme definovali následující hodnotící metriky. Hrana je správná tehdy a jen tehdy, když stejná hrana existuje v grafu „zlatého standardu“ a orientace hrany se shoduje s orientací v grafu „zlatého standardu“; hrana je semisprávná tehdy a jen tehdy, když stejná hrana existuje v grafu „zlatého standardu“ a její orientace není v rozporu se skutečnou orientací hrany v grafu „zlatého standardu“; A konečně hrana je nesprávná, pokud hrana v grafu „zlatého standardu“ neexistuje nebo pokud existuje, ale její orientace je opačná než je skutečná orientace.
Představíme vám následující metriky:
1. Počet správných, polosprávných, nesprávných hran
2. Přesnost: poměr správných nebo polosprávných hran ke všem hranám hlášeným algoritmem
3. Připomeňme si: podíl hran v grafu „zlatého standardu“, který je správný nebo polosprávně hlášený
4. Míra výskytu: procento přilehlosti se zobrazí ve výsledku 100 spuštění bootstrapu
Výsledek
studie kauzálního objevu. V této části jsou uvedeny objevené kauzální struktury generované algoritmy SEM, FCI a FGES napříč třemi stupni předchozích "znalostí". Zákulisní mechanismus typických chyb bude dále zkoumán v sekci diskuse.
Experiment 1: Bez znalosti pozadí. Na obr. 3 uvádíme okraje s alespoň 80procentním výskytem v 100 vzorcích bootstraps (číslo Te se nachází poblíž každé hrany). Okraje, které nebyly v grafu zlatého standardu, jsou zbarveny červeně. Čísla napravo od každého grafu představují přesnost, zapamatovatelnost a počet správných, polosprávných a nesprávných hran zprůměrovaných na 100 vzorků bootstrapu. Pro usnadnění přímého srovnání jsou proměnné uspořádány téměř identicky: stejná proměnná zaujímá stejné relativní umístění ve všech třech grafech. SEM byl schopen získat pouze dvě správné hrany z grafu „zlatého standardu“ (s průměrnou přesností 0,24 a vyvoláním 0,30), zatímco FCI a FGES nalezly 4 z 8 hran správně nebo polosprávně (přesnost 0,24 a 0,44, vyvolat 0,46 a 0,6 odpovídajícím způsobem). FCI i FGES úspěšně obnovily kauzální vztah mezi genetickou proměnnou APOE41 s ABETA, ABETA s FDG a FDG, PTAU s DX. Algoritmy však nedokázaly určit směrovost některých vztahů. Také jsme pozorovali, že všechny tři algoritmy vykazovaly hrany od biomarkerů k demografickým proměnným, což jsou jistě chyby (např. ABETA způsobuje APOE42 v grafu FCI). Je důležité poznamenat, že některé dobře zavedené vztahy, jako je věk a amyloid, stejně jako vzdělání a diagnóza, nebyly objeveny v žádném z grafů, které neměly základní znalosti.
Experiment 2: Doplnění triviálních základních znalostí. Obrázek 4 ukazuje kauzální struktury objevené třemi algoritmy zahrnujícími triviální základní znalosti: demografické proměnné nemohou být způsobeny jinými demografickými proměnnými ani biomarkery (např. věk účastníka není ovlivněn vzděláním nebo úrovní ABETA). Struktura na obr. 4 je analogická s obr. 3.
Zatímco všechny metody dělaly několik chyb, došlo k výraznému zlepšení, když byly přidány triviální informace o pozadí. Některé z nesprávných příčin zjištěných SEM jsou ve skutečnosti nepřímé příčinné vztahy ve „zlatém standardu“. Například efekt z APOE42 na DX je nepřímý efekt, který protéká ABETA v grafu „zlatého standardu“. Všechny tři algoritmy objevily hranu ABETA →DX. Ačkoli to není přímý kauzální účinek v našem grafu "zlatého standardu", ABETA je běžnou příčinou snížení FDG i zvýšení PTAU a FDG i PTAU vedou k DX. Proto bylo možné očekávat účinek ABETA a DX. FCI i FGES hlásily falešně nasměrovanou hranu mezi PTAU a DX. Uvidíme, že tato chyba je opravena pomocí podélných dat. Algoritmus FCI také hlásil neměřené zmatky mezi PTAU a DX s FDG, což jsou zajímavé hypotézy, které vyžadují další studie. Mezi těmito třemi algoritmy dosáhl SEM nejnižšího výkonu (přesnost 0.31, vzpomínka 0.39), zatímco FCI a FGES dosáhly vyššího a podstatně vyššího výkonu (FCI: 0.42 přesnost a 0.55 odvolání; FGES {{10}}.71 přesnost a 0.68 odvolání).
Experiment 3: Doplnění longitudinálních dat a triviálních základních znalostí. Obrázek 5 představuje nejčastější hrany objevené těmito třemi algoritmy a jejich výkonnostní metriky. Uspořádání grafů se liší od předchozích obrázků, protože jsou postaveny na podélném souboru dat. Všechny uzly spojené s biomarkery nebo diagnózou se tedy objevují dvakrát: jednou se svou výchozí hodnotou (označenou příponou '0.0') a jednou po 24 měsících (označenou '0. přípona 24'). Většina statistik se oproti předchozím výsledkům dále zlepšila a FGES obnovil graf pouze s jednou nesprávnou hranou.
Výkon algoritmu SEM zaostával za dalšími dvěma vyhrazenými algoritmy kauzálního zjišťování. V některých bootstrapových běhech SEM postrádal přímé účinky mezi podélnými měřeními stejného biomarkeru (např. odhadovaná pravděpodobnost, že SEM objeví okraj ABETA.{{0}} →ABETA.24 je 0,47, kde FCI a FGES vždy zahrnují tuto hranu).
Algoritmus FCI dále identifikoval, že PTAU při úvodní návštěvě má vliv na diagnózu (AD) ve 24. měsíci. Jinými slovy, PTAU může mít opožděný účinek na diagnózu AD, což je vysoce pravděpodobná hypotéza. Také jsme pozorovali, že VĚK a VZDĚLÁNÍ vedou k odlišné FDG a diagnóze při první návštěvě, ale ne přímo k hodnocení ve 24. měsíci (po úpravě hodnocení na základní návštěvě).
Algoritmus FGES začlenil podélná data a úspěšně objevil hranu FDG na DX. Také to odstranilo nesprávné hrany z DX na PTAU. Navíc s podélnými daty byly dříve neorientované hrany identifikované pomocí FGES nasměrovány, aniž by byla ohrožena celková přesnost a zapamatovatelnost.
S eM-recovery study.Tabulka 2 ukazuje statistiky, když jsme testovali schopnost SEM obnovit smazané hrany z grafu „zlatého standardu“. V každém běhu jsme odstranili jednu hranu nebo pár hran. „Úplná míra obnovy“ představuje procento běhů, ve kterých se SEM podařilo plně obnovit odstraněné hrany. Sloupce "přesnost" a "vyvolání" jsou definovány stejným způsobem jako v předchozích experimentech. Jak můžeme vidět z tabulky 2, když jsme odstranili pouze jeden okraj, míra obnovy je velmi nízká (12,5 procenta). Když jsme odstranili dvě hrany z grafu „zlatého standardu“, SEM nebyl schopen obnovit skutečný graf.
Diskuse
V této studii jsme porovnali tři různé metodiky, abychom znovu vytvořili známou kauzální strukturu základní pravdy na základě pozorovacího souboru dat pomocí tří různých stupňů „znalostí“. Použili jsmeAlzheimerova chorobadata z ADNI, což je dobře charakterizovaná otevřená datová sada. Vzhledem k tomu, že vztahy mezi biomarkery a diagnózou vAlzheimerova chorobajsou dobře srozumitelné, začali jsme s kauzální strukturou „zlatého standardu“ založenou na existující literatuře. Deset, použili jsme tři algoritmy k odhalení této kauzální struktury z dat. Tato práce upozorňuje na běžné chyby, kterých se různé algoritmy dopouštějí, a nabízí nám nápady a návrhy, jak se těmto chybám vyhnout. Na závěr byl poskytnut podrobný návod, jak lze použít algoritmus kauzálního zjišťování k odhalení vysoce kvalitních kauzálních vztahů.
Každý ze tří algoritmů použitých v této práci představuje třídu algoritmů se svými specifickými vlastnostmi. Dva z těchto algoritmů, FCI a FGES, jsou vyhrazené algoritmy kauzálního zjišťování, zatímco třetí, SEM, je primárně navržen jako potvrzující nástroj. Vyhrazené algoritmy kauzálního zjišťování překonaly SEM ve všech třech stupních znalostí. To není překvapivé, protože SEM není specificky navržen pro objevování kauzální struktury; statistiky hlášené SEM pouze naznačují možné úpravy a priori uživatelem definované kauzální struktury. Překvapivý je rozsah, v jakém FGES překonal SEM, protože FGES i SEM optimalizují stejné kritérium, kterým je BIC. Klíčovým rozdílem mezi FGES a SEM je měřítko základního vyhledávacího prostoru: FGES zvažuje širší pole grafů, všechny grafy, které mají stejnou strukturu závislosti (stejný soubor podmíněných nezávislých vztahů mezi proměnnými). Z experimentu SEM-recovery jsme také pozorovali, že návrhy SEM pro přidání hran nejsou obecně spolehlivé. Tyto okraje mohou maximalizovat BIC v omezeném vyhledávacím prostoru SEM, ale nejsou to celkově optimální okraje: FGES se svým větším vyhledávacím prostorem dokázal (téměř dokonale) obnovit graf „zlatého standardu“.
Vzhledem k tomu, že FCI a FGES mají podobné vyhledávací prostory, hlavní rozdíly mezi nimi spočívají v jejich vyhledávacím algoritmu. Výkon algoritmu FGES založeného na skóre byl v naší studii vyšší a stabilnější než algoritmus FCI založený na omezeních. Rozhodování FCI bylo ovlivněno nesprávnými testy nezávislosti zavedenými výběrovým zkreslením nebo datovými artefakty. Tyto chyby se rozšířily do dalších částí grafu generováním nesprávných struktur „V“ nebo „Y“ a nakonec způsobily poškození velkých částí grafu. Naproti tomu algoritmy založené na skóre berou v úvahu pravděpodobnost globální struktury při místním rozhodování; takže tyto chyby zůstávají lokalizovány. To vysvětluje, proč je objevená struktura FGES před nebo po přidání znalostí trivia více konzistentní. FCI má tu výhodu, že dokáže uvolnit typický předpoklad, že neexistují žádné neměřené zmatky. Tato relaxace může být užitečná, když je důležité buď identifikovat neměřené zmatky nebo financovat neopodstatněné kauzální vztahy. V naší studii FCI zjistila, že vztah mezi ABETA a FDG není zkreslený a že mezi FDG, DX mohou existovat neměřené zmatky (obr. 4-FCI)
Dále jsme zkoumali chyby, kterých se FCI a FGES dopustily. Tyto chyby jsme seskupili do tří kategorií a jejich příčiny a řešení jsme popsali v tabulce 3.
1. První druh chyby nastane, když artefakty v datech způsobí nesprávné hrany. Například FCI uvedlo rozdíl mezi EDU a SEX (obr. 3-FCI), protože v našem vzorku je průměrná úroveň vzdělání mužských účastníků vyšší. Vyhýbání se takovým nesprávným okrajům je důležité, protože mohou potenciálně vytvářet nesprávné struktury „V“ nebo „Y“, které ohrozí zbývající kroky kauzálního zjišťování. Přidání triviálních znalostí o pozadí může tento problém vyřešit tím, že zabrání algoritmům, aby považovaly asociaci za příčinnou souvislost.
2. Nejsou-li k dispozici všeobecně uznávané základní znalosti, je kompenzace datových artefaktů obtížnější a může mít vzdálené následné účinky. Například struktura APOE42-PTAU-FDG byla v některých spuštěních bootstrapu odvozena jako struktura „V“ (APOE42 →PTAU ←FDG). Tato chyba byla výsledkem jediné nesprávně odvozené nezávislosti mezi APOE42 a FDG na vzorových datech. Tato chyba se šířila prostřednictvím tří asociací mezi (1) APOE42 a PTAU, (2) PTAU a FDG a (3) APOE42 a FDG podmíněné PTAU, což vedlo ke struktuře „V“ mezi těmito třemi. Této hraně nemůžeme zabránit pomocí znalosti pozadí, pokud předem neznáme vztahy podmíněné nezávislosti mezi APOE42 a FDG. Použití longitudinálních dat pomohlo napravit tyto chyby; jak můžeme vidět na obr. 5-FCI, při použití podélných dat byla korigována spodní struktura.
3. Zatímco longitudinální data poskytují řešení řady problémů, požadavek na opakovaná pozorování může omezit velikost vzorku a zavést některé vlastní chyby. FCI například objevila možný opožděný vztah mezi PTAU v čase 0 a DX v měsíci 24 (obr. 5-FCI), nicméně stejný vztah není pozorován ve výsledcích z FGES (obr. 5-FGES) – možná kvůli malé velikosti vzorku.
V longitudinální studii není zaručeno, že místní struktury napříč časovými body budou stejné. Například v grafu objeveném FGES způsobuje ABETA.{{0}} PTAU.0, ale ABETA.24 nezpůsobuje PTAU.24. Důvodem je, že ABETA.{6}} je společným rodičem ABETA.24 a PTAU.0. PTAU.24 je podmíněně nezávislý na ABETA.24 daný buď ABETA.{{10}} nebo PTAU.0. Tento vztah podmíněné nezávislosti znamená, že v přítomnosti ABETA.0 nebo PTAU.0 není ABETA.24 potřeba k vysvětlení variace v PTAU.24.
I když konečný graf získaný z pozorovacích dat těsně odpovídal grafu „zlatého standardu“, naše závěry stále závisí na správnosti „zlatého standardu“. Obecně máme velkou důvěru v graf „zlatého standardu“, protože biologický mechanismus za kaskádou biomarkerů AD je dobře pochopen a FGES dokázala objevit „zlatý standard“ téměř dokonale. Je však vysoce možné, že FDG a PTAU vysvětlují pouze část účinku ABETA na diagnózu AD; může existovat přímá příčina z ABETA na DX. Ačkoli doporučujeme longitudinální data, longitudinální sběr dat je často nákladný, což obvykle vede k menší velikosti vzorku. Malá velikost vzorku snižuje statistickou sílu v algoritmu kauzálního zjišťování, což je kompromis. Pokusili jsme se zmenšit velikost vzorku o 50 procent a 75 procent a provedli jsme stejnou analýzu. Když jsme zmenšili velikost vzorku o 50 procent, celkový počet objevených hran ve 100 iteracích bootstrapu se snížil. Avšak hrany, které byly konzistentně objeveny na úplném vzorku, byly konzistentně objeveny také na zmenšeném vzorku. Dosáhli jsme podobné přesnosti a zapamatovatelnosti. Když jsme dále zmenšili velikost vzorku (celkem o 75 procent), celkový počet hran se dále zmenšil. Zatímco nejčastěji objevované hrany byly nadále objevovány, počet „šumových hran“, hran, které byly objeveny pouze v několika iteracích bootstrapu, vzrostl.
Závěrem lze říci, že specializované algoritmy kauzálního zjišťování překonaly SEM v objevování kauzální struktury. Při analýze dat v reálném světě měla kvalita dat vliv na správnost objevené struktury. Začlenění předchozích znalostí a použití longitudinálních dat může zlepšit objevený výsledek tím, že zabrání tomu, aby algoritmy dělaly některé potenciální chyby.
1. První druh chyby nastane, když artefakty v datech způsobí nesprávné hrany. Například FCI uvedlo rozdíl mezi EDU a SEX (obr. 3-FCI), protože v našem vzorku je průměrná úroveň vzdělání mužských účastníků vyšší. Vyhýbání se takovým nesprávným okrajům je důležité, protože mohou potenciálně vytvářet nesprávné struktury „V“ nebo „Y“, které ohrozí zbývající kroky kauzálního zjišťování. Přidání triviálních znalostí o pozadí může tento problém vyřešit tím, že zabrání algoritmům, aby považovaly asociaci za příčinnou souvislost.
2. Nejsou-li k dispozici všeobecně uznávané základní znalosti, je kompenzace datových artefaktů obtížnější a může mít vzdálené následné účinky. Například struktura APOE42-PTAU-FDG byla v některých spuštěních bootstrapu odvozena jako struktura „V“ (APOE42 →PTAU ←FDG). Tato chyba byla výsledkem jediné nesprávně odvozené nezávislosti mezi APOE42 a FDG na vzorových datech. Tato chyba se šířila prostřednictvím tří asociací mezi (1) APOE42 a PTAU, (2) PTAU a FDG a (3) APOE42 a FDG podmíněné PTAU, což vedlo ke struktuře „V“ mezi těmito třemi. Této hraně nemůžeme zabránit pomocí znalosti pozadí, pokud předem neznáme vztahy podmíněné nezávislosti mezi APOE42 a FDG. Použití longitudinálních dat pomohlo napravit tyto chyby; jak můžeme vidět na obr. 5-FCI, při použití podélných dat byla korigována spodní struktura.
3. Zatímco longitudinální data poskytují řešení řady problémů, požadavek na opakovaná pozorování může omezit velikost vzorku a zavést některé vlastní chyby. FCI například objevila možný opožděný vztah mezi PTAU v čase 0 a DX v měsíci 24 (obr. 5-FCI), nicméně stejný vztah není pozorován ve výsledcích z FGES (obr. 5-FGES) – možná kvůli malé velikosti vzorku.
V longitudinální studii není zaručeno, že místní struktury napříč časovými body budou stejné. Například v grafu objeveném FGES způsobuje ABETA.{{0}} PTAU.0, ale ABETA.24 nezpůsobuje PTAU.24. Důvodem je, že ABETA.{6}} je společným rodičem ABETA.24 a PTAU.0. PTAU.24 je podmíněně nezávislý na ABETA.24 daný buď ABETA.{{10}} nebo PTAU.0. Tento vztah podmíněné nezávislosti znamená, že v přítomnosti ABETA.0 nebo PTAU.0 není ABETA.24 potřeba k vysvětlení variace v PTAU.24.
I když konečný graf získaný z pozorovacích dat těsně odpovídal grafu „zlatého standardu“, naše závěry stále závisí na správnosti „zlatého standardu“. Obecně máme velkou důvěru v graf „zlatého standardu“, protože biologický mechanismus za kaskádou biomarkerů AD je dobře pochopen a FGES dokázala objevit „zlatý standard“ téměř dokonale. Je však vysoce možné, že FDG a PTAU vysvětlují pouze část účinku ABETA na diagnózu AD; může existovat přímá příčina z ABETA na DX. Ačkoli doporučujeme longitudinální data, longitudinální sběr dat je často nákladný, což obvykle vede k menší velikosti vzorku. Malá velikost vzorku snižuje statistickou sílu v algoritmu kauzálního zjišťování, což je kompromis. Pokusili jsme se zmenšit velikost vzorku o 50 procent a 75 procent a provedli jsme stejnou analýzu. Když jsme zmenšili velikost vzorku o 50 procent, celkový počet objevených hran ve 100 iteracích bootstrapu se snížil. Avšak hrany, které byly konzistentně objeveny na úplném vzorku, byly konzistentně objeveny také na zmenšeném vzorku. Dosáhli jsme podobné přesnosti a zapamatovatelnosti. Když jsme dále zmenšili velikost vzorku (celkem o 75 procent), celkový počet hran se dále zmenšil. Zatímco nejčastěji objevované hrany byly nadále objevovány, počet „šumových hran“, hran, které byly objeveny pouze v několika iteracích bootstrapu, vzrostl.
Závěrem lze říci, že specializované algoritmy kauzálního zjišťování překonaly SEM v objevování kauzální struktury. Při analýze dat v reálném světě měla kvalita dat vliv na správnost objevené struktury. Začlenění předchozích znalostí a použití longitudinálních dat může zlepšit objevený výsledek tím, že zabrání tomu, aby algoritmy dělaly některé potenciální chyby.

Reference
1. Beam, AL & Kohane, IS Big Data a strojové učení ve zdravotnictvíVelká data a strojové učení ve zdravotnictvíVelká data a strojové učení ve zdravotnictví. JAMA 319, 1317–1318, https://doi.org/10.1001/jama.2017.18391 (2018).
2. Murdoch, TB & Detsky, AS Te Nevyhnutelná aplikace velkých dat ve zdravotnictví Nevyhnutelná aplikace velkých dat ve zdravotnictví. JAMA 309, 1351–1352.
3. Trister, AD, Buist, DSM & Lee, CI Vychýlí strojové učení rovnováhu při screeningu rakoviny prsu? Zhorší strojové učení rovnováhu při screeningu rakoviny prsu? Nakloní strojové učení rovnováhu při screeningu rakoviny prsu? JAMA Oncology 3, 1463–1464.
4. Rogers, MB Tere's No Tomorrow for TOMORROW. ALZFORUM.
5. Arvanitakis, Z. a kol. Diabetes souvisí s mozkovým infarktem, ale ne s patologií AD u starších osob. Neurologie 67, 1960–1965.
6. Vemuri, P. a kol. Věk, vaskulární zdraví a biomarkery Alzheimerovy choroby u staršího vzorku. Ann. Neurol. 82, 706-718.
7. Jack, CR Jr. a kol. Sledování patofyziologických procesů u Alzheimerovy choroby: aktualizovaný hypotetický model dynamických biomarkerů. Lancet Neurol. 12, 207–216, https://doi.org/10.1016/s1474-4422(12)70291-0 (2013).
8. Pearl, J. Kauzalita: Modely, uvažování a vyvozování. sv. 64 (Cambridge University Press, 2000).
9. Spirtes, P., Meek, C. & Richardson, TS Causal Inference in the Presence of Latent Variables and Selection Bias. CoRR abs/1302.4983 (2013).
10. Ramsey, JD Zvětšování hladovějící ekvivalence Hledání spojitých proměnných. CoRR abs/1507.07749 (2015).
11. Chickering, DM Optimální identifikace struktury s Greedy Search. Journal of Machine Learning Research 3, 507–554 (2002).
12. Mani, S., Spirtes, P. & Cooper, GF Teoretická studie struktur Y pro kauzální objev. CoRR abs/1206.6853 (2012).
13. Spirtes, P., Clark, G. & Scheines, R. Příčina, předpověď a hledání. (Te MIT Press, 2000).
14. Schwarz, G. Odhad rozměru modelu. The Annals of Statistics 6, 461–464.
15. Meek, C. Grafické modely: Výběr kauzálních a statistických modelů, (1997).
16. Kline, RB Principy a praxe modelování strukturních rovnic, 3. vydání. 265–295 (Guilford Press, 2011).
17. Heckerman, D., Meek, C. & Cooper, G. In Innovations in Machine Learning: Theory and Applications (eds. Dawn E. Holmes & Lakhmi C. Jain) 1–28 (Springer Berlin Heidelberg, 2006).
18. Rosseel, Y. lavaan: Balíček R pro modelování strukturních rovnic. Journal of Statistical Sofware 48, 36, https://doi.org/10.18637/ jss.v048.i02 (2012).
19. Weiner, MW a kol. Impact of the Alzheimer's Disease Neuroimaging Initiative, 2004 až 2014. Alzheimer's & demence: Journal of the Alzheimer's Association 11, 865–884.
20. Mishra, S. a kol. Longitudinální zobrazování mozku u preklinické Alzheimerovy choroby: dopad genotypu APOE epsilon4. Mozek 141, 1828–1839.